Hinweis: Erklärungen und Tipps zur Abfrage „Ich bin kein Roboter“ bei der Google-Suche finden Sie weiter unten im Artikel.
Ab Seite 40 liefert der Scraper plötzlich nur noch leere Zeilen. Eine Fehlermeldung gibt es oft nicht, erst ein Blick auf die geladene Seite zeigt den Grund: Statt der Produktliste erscheint eine reCAPTCHA-Abfrage. reCAPTCHA hat die Zugriffe als automatisiert eingestuft, etwa weil in kurzer Zeit sehr viele Anfragen von derselben IP-Adresse kamen oder der Browser typische Automatisierungsmerkmale zeigte.
CAPTCHAs beim Scraping zu umgehen heißt in der Praxis vor allem zweierlei: die Abfrage seltener auslösen und die verbleibenden Abfragen automatisch lösen lassen. Beides funktioniert auch ohne Programmierkenntnisse.
Kurz gesagt: drei Wege, mit CAPTCHAs beim Scraping umzugehen
- Seltener auslösen: Anfragen drosseln, über wechselnde IP-Adressen verteilen und mit einem echten Browser statt mit reinen HTTP-Anfragen arbeiten. So erscheint ein Großteil der Abfragen gar nicht erst.
- Automatisch lösen lassen: In Octoparse löst der Schritt „CAPTCHA lösen“ Bild-CAPTCHAs, reCAPTCHA v2 und v3 sowie Cloudflare-Prüfungen während der Datenerfassung. Code ist dafür nicht nötig.
- Selbst entwickeln: mit Selenium oder Playwright, bei Bedarf ergänzt um einen externen Solver-Dienst. Das bietet volle Kontrolle, verlangt aber Programmierkenntnisse und laufende Pflege.
Unabhängig vom Weg gilt: Erfassen Sie nur öffentlich zugängliche Daten und prüfen Sie vorher die Nutzungsbedingungen der Website.
4 verschiedene Arten von reCAPTCHA
reCAPTCHA ist Googles Dienst zur Bot-Erkennung und auf sehr vielen Websites im Einsatz. Für Scraper ist die Version entscheidend: Sie bestimmt, ob überhaupt eine sichtbare Abfrage erscheint und ob sie sich automatisch lösen lässt.
1. reCAPTCHA v2 (Kontrollkästchen „Ich bin kein Roboter“)
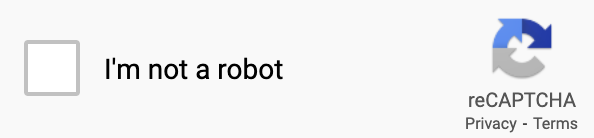
Die bekannteste Variante: Nutzer setzen ein Häkchen im Kästchen „Ich bin kein Roboter“. Im Hintergrund bewertet Google dabei unter anderem Mausbewegungen, Cookies und die IP-Adresse. Wirkt die Sitzung verdächtig, folgt eine Bildaufgabe, etwa „Wählen Sie alle Bilder mit Ampeln aus“. Für Scraper: Diese Variante lässt sich in Octoparse automatisch lösen.
2. reCAPTCHA v2 Invisible
Hier gibt es kein Kästchen. Die Prüfung startet unbemerkt, sobald jemand ein Formular absendet oder einen Button anklickt. Nur bei Verdacht erscheint dieselbe Bildaufgabe wie bei v2. Für Scraper: Die Abfrage taucht oft erst beim Klick auf „Suchen“ oder „Weiter“ auf, also mitten im Ablauf und nicht schon beim Laden der Seite.
3. reCAPTCHA v3 (Score-basiert)
reCAPTCHA v3 zeigt überhaupt keine Aufgabe. Stattdessen vergibt Google für jede Anfrage einen Score zwischen 0,0 (wahrscheinlich Bot) und 1,0 (wahrscheinlich Mensch). Was bei einem niedrigen Score passiert, legt die Website selbst fest: Sie kann den Zugriff sperren oder eine zusätzliche Prüfung verlangen. Für Scraper: Es gibt keine Aufgabe, die sich anklicken ließe. Octoparse bietet zwar einen eigenen Typ für reCAPTCHA v3, am Ende entscheidet aber der Score. Ob der Zugriff durchgeht, hängt deshalb auch davon ab, wie unauffällig die Aufgabe insgesamt läuft.
4. reCAPTCHA Enterprise
Die Unternehmensversion läuft über Google Cloud, arbeitet überwiegend mit Scores wie v3 und gibt der Website zusätzliche Begründungen und feinere Einstellungen an die Hand. Eingesetzt wird sie vor allem dort, wo viel auf dem Spiel steht: bei Logins, Zahlungen und Kundenkonten, etwa von Banken und großen Onlineshops. Für Scraper: Wer auf Enterprise trifft, bewegt sich meist in einem sensiblen Bereich. Spätestens hier sollten Sie prüfen, ob die Datenerfassung überhaupt zulässig ist.
Andere CAPTCHAs: hCaptcha und Cloudflare Turnstile
Nicht jede Abfrage stammt von Google. hCaptcha funktioniert ähnlich wie reCAPTCHA v2 mit Kästchen und Bildaufgaben und wird häufig als datenschutzfreundlichere Alternative eingesetzt. Cloudflare Turnstile prüft den Browser dagegen meist unsichtbar im Hintergrund, oft zusammen mit weiteren Schutzmechanismen von Cloudflare. Wie Sie mit solchen Prüfungen beim Scraping zurechtkommen, zeigt unser Beitrag Cloudflare-CAPTCHA beim Web Scraping umgehen.
Ist es legal, reCAPTCHA zu überspringen?
Ein Gesetz, das das Lösen von CAPTCHAs ausdrücklich verbietet, gibt es in Deutschland nicht. Ob eine Datenerfassung zulässig ist, hängt aber von mehreren Punkten ab, und ein CAPTCHA kann dabei durchaus ins Gewicht fallen.
- Wettbewerbsrecht: Der Bundesgerichtshof hat 2014 entschieden, dass das automatisierte Auslesen frei zugänglicher Daten grundsätzlich keine unlautere Behinderung ist. Ein Verbot in den Nutzungsbedingungen allein reicht dafür nicht aus. Anders kann es aussehen, wenn eine technische Schutzvorrichtung überwunden wird: Darin kann nach Auffassung des Gerichts ein Unlauterkeitsmoment liegen (BGH, Urteil vom 30.04.2014, Az. I ZR 224/12, „Flugvermittlung im Internet“). Ob ein CAPTCHA im Einzelfall als solche Schutzvorrichtung gilt, ist gerichtlich nicht abschließend geklärt. Naheliegend ist es.
- Datenbankrecht: Wer eine Datenbank ganz oder in wesentlichen Teilen übernimmt, kann das Recht des Datenbankherstellers verletzen. Das gilt auch für das wiederholte, systematische Abgreifen kleinerer Teile, wenn es die normale Auswertung der Datenbank beeinträchtigt (§ 87b UrhG).
- Datenschutz: Sobald personenbezogene Daten im Spiel sind, etwa Namen, E-Mail-Adressen oder Telefonnummern von Privatpersonen, gilt die DSGVO. Sie brauchen dann eine Rechtsgrundlage und müssen Betroffene in der Regel informieren.
- Login-Bereiche: Daten hinter einem Login unterliegen den Bedingungen, denen Sie bei der Anmeldung zugestimmt haben. Wer ein CAPTCHA löst, um sich Zugang zu fremden Konten zu verschaffen, bewegt sich nicht mehr in einer Grauzone.
Für die Praxis heißt das: Je seltener ein Scraper CAPTCHAs auslöst, desto besser, technisch wie rechtlich. Erfassen Sie öffentlich zugängliche Sachdaten in einem Tempo, das den Server nicht belastet, und prüfen Sie robots.txt und Nutzungsbedingungen vorab. Dieser Abschnitt ersetzt keine Rechtsberatung. Einen ausführlichen Überblick gibt unser Beitrag Ist Web Scraping in Deutschland legal?
2 Methoden zum Umgehen von reCAPTCHA
Hat ein Scraper eine CAPTCHA-Abfrage einmal ausgelöst, gibt es zwei Wege, sie zu lösen: mit einem Tool, das diesen Schritt übernimmt, oder mit eigenem Code. Der Unterschied liegt weniger im Ergebnis als im Aufwand, den Sie dauerhaft tragen.
Methode 1: CAPTCHAs in Octoparse automatisch lösen (ohne Code)
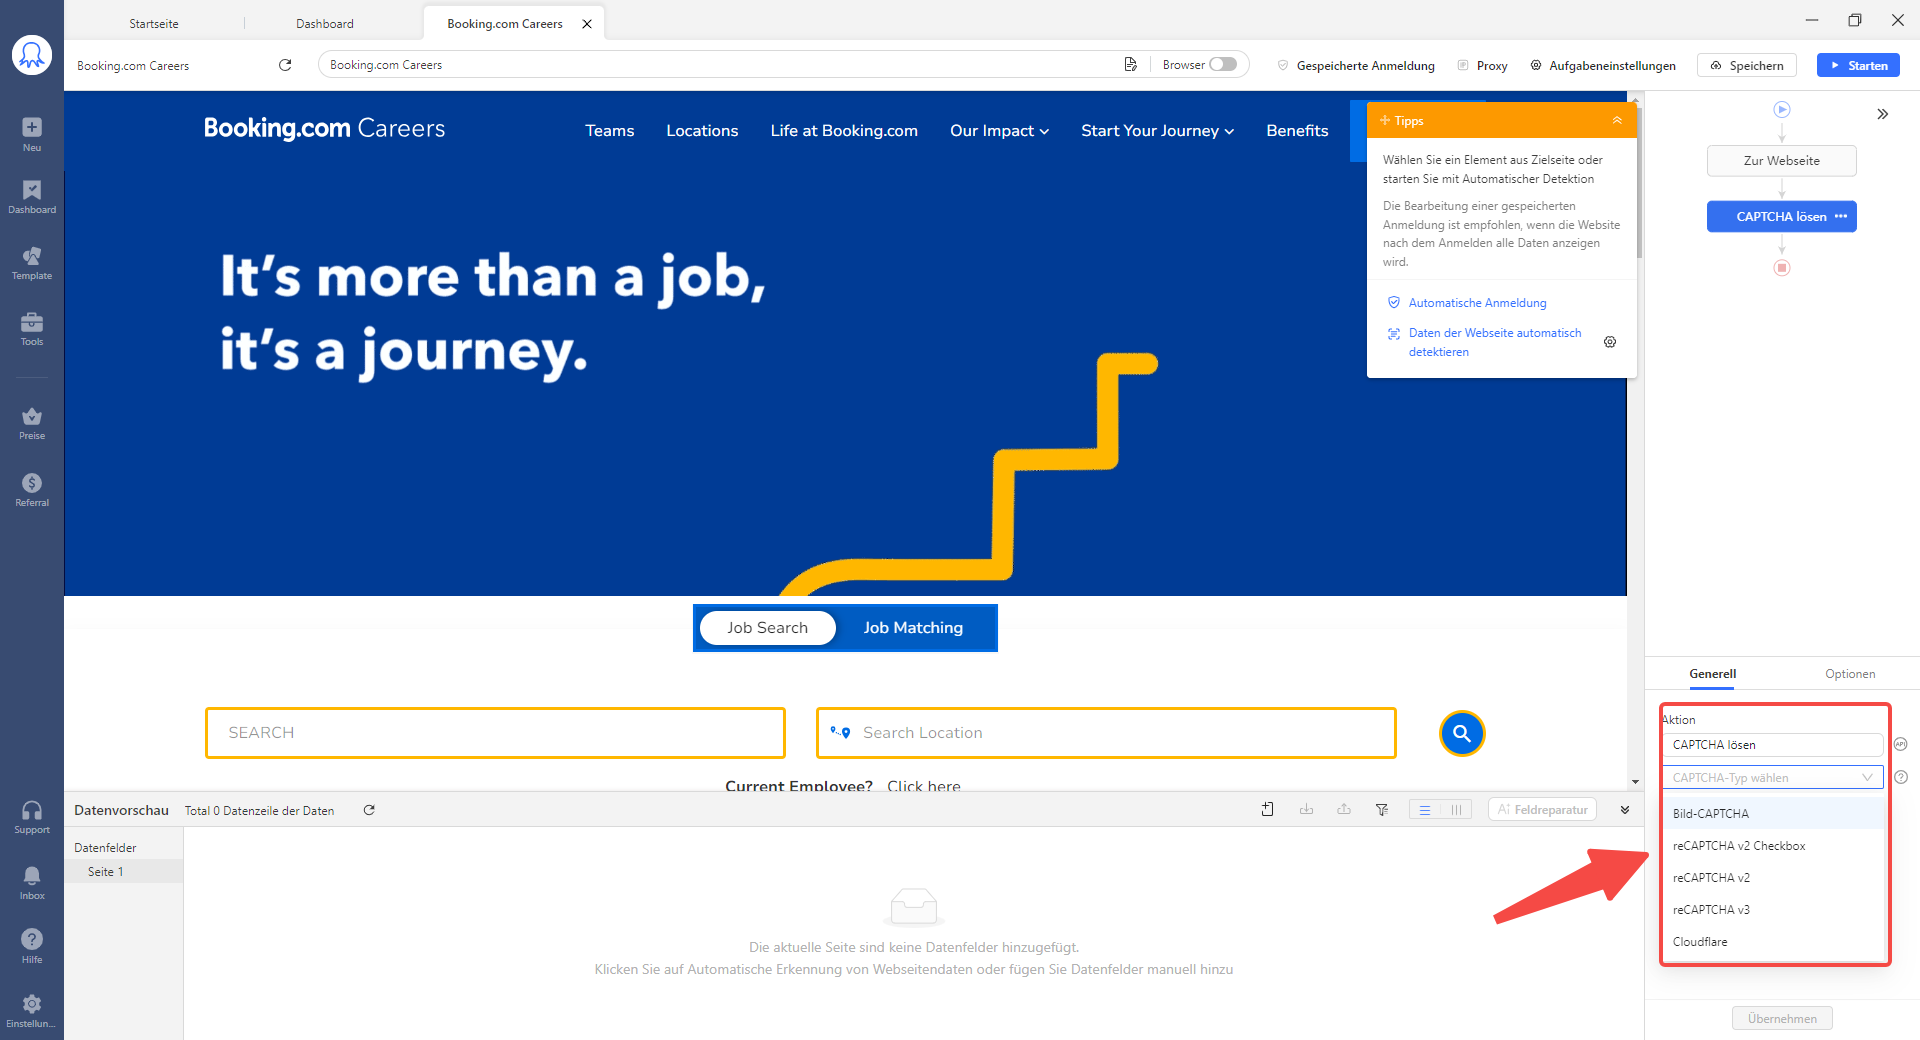
Octoparse erfasst Daten in einem echten Browser und lässt Aufgaben auf Wunsch in der Cloud laufen, wo Anfragen über wechselnde IP-Adressen verteilt werden. Allein das verringert die Zahl der Abfragen deutlich. Für die übrigen gibt es einen eigenen Schritt im Ablauf: „CAPTCHA lösen“. Er verarbeitet Bild-CAPTCHAs, reCAPTCHA v2 (mit und ohne Kästchen), reCAPTCHA v3 und Cloudflare-Prüfungen automatisch, sobald sie während der Datenerfassung auftauchen.
- Aufgabe anlegen: Ziel-URL einfügen und die Seite automatisch erkennen lassen.
- Schritt einfügen: An der Stelle im Ablauf, an der das CAPTCHA erscheint, über „Hinzufügen“ den Schritt „CAPTCHA lösen“ ergänzen.
- CAPTCHA-Typ wählen: Bild-CAPTCHA, reCAPTCHA v2 Checkbox, reCAPTCHA v2, reCAPTCHA v3 oder Cloudflare. Bei Bild-CAPTCHAs geben Sie zusätzlich den XPath des Bildes an. Hat die Abfrage einen eigenen Absende-Button, folgt danach ein Klick-Schritt auf diesen Button.
- Beim Einrichten einmal selbst lösen: reCAPTCHA wird erst im echten Lauf automatisch gelöst. Solange Sie die Aufgabe aufbauen, schalten Sie oben den Browser-Modus ein und lösen die Abfrage von Hand.
- Guthaben prüfen und starten: Abgerechnet wird pro Lösungsversuch über ein separates Guthaben. Octoparse berechnet dafür 1 $ pro 1.000 Versuche (Stand 10/2026). Ein einzelnes CAPTCHA kann mehrere Versuche brauchen. Ist das Guthaben aufgebraucht, bleibt die Aufgabe an der nächsten Abfrage hängen.
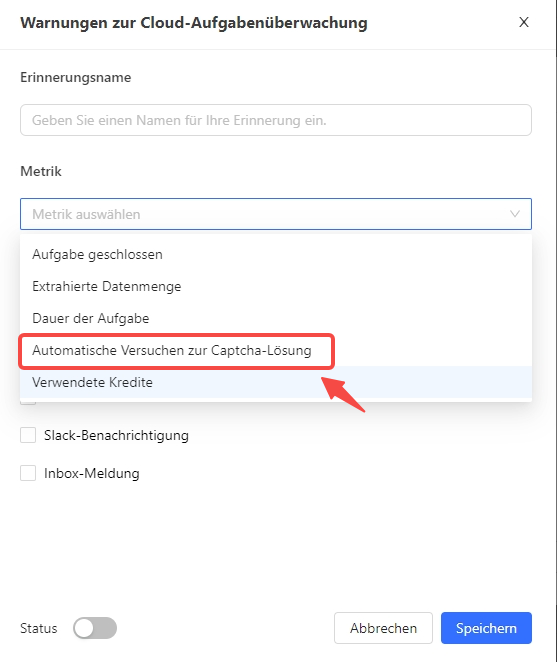
Zwei Ergänzungen machen den Ablauf robuster. Für Cloudflare-Prüfungen gibt es zwei Wege: den Typ „Cloudflare“ direkt in diesem Schritt oder die kostenpflichtige Option „Cloudflare mit Guthaben lösen“ unter „Anti-Blockierung“ in den Aufgabeneinstellungen, die solche Prüfungen für die gesamte Aufgabe übernimmt. Und über eine Warnung zur Cloud-Aufgabenüberwachung behalten Sie die Zahl der automatischen CAPTCHA-Lösungsversuche im Blick: Steigt sie plötzlich an, hat die Website ihren Schutz vermutlich verschärft, und Sie bemerken es, bevor das Guthaben aufgebraucht ist.
Eine Einschränkung bleibt bei reCAPTCHA v3: Hier gibt es keine Aufgabe, die gelöst wird, sondern einen Score, den die Website auswertet. Der Schritt „CAPTCHA lösen“ verbessert die Chancen, ersetzt aber nicht die Maßnahmen aus dem Abschnitt weiter unten, die dafür sorgen, dass die Aufgabe gar nicht erst verdächtig wirkt.
Methode 2: Eigener Code mit Browser-Automatisierung und Solver-Diensten
Mit Selenium, Puppeteer oder Playwright steuern Sie einen echten Browser per Code. Das löst noch kein CAPTCHA, senkt aber die Zahl der Abfragen, weil die Zugriffe einem normalen Besuch ähneln: Seiten werden vollständig gerendert, Cookies bleiben erhalten, Klicks und Wartezeiten lassen sich steuern.
Für die Abfragen, die trotzdem erscheinen, binden viele Entwickler einen Solver-Dienst an. Der Scraper schickt die Kennung des CAPTCHAs per API an den Dienst, dort wird die Aufgabe automatisiert oder von Menschen gelöst, und der Scraper erhält ein Token zurück, das er an die Website übermittelt. Abgerechnet wird meist pro 1.000 gelöste CAPTCHAs. Die Grenzen sind dieselben wie oben: Bei reCAPTCHA v3 entscheidet weiterhin der Score, ein Token allein garantiert keinen Zugang. Zudem dauert jede Lösung einige Sekunden und bremst damit die Erfassung.
Dieser Weg bietet die meiste Kontrolle, verlangt aber Programmierkenntnisse und laufende Pflege: Ändert die Website ihren Aufbau oder ihren Schutz, muss der Code angepasst werden. Warum Scraper nach solchen Änderungen ausfallen und wie Sie den Wartungsaufwand senken, zeigt unser Beitrag Web Scraper kaputt? 5 Ursachen und was wirklich hilft.
6 Tipps, damit reCAPTCHA beim Scraping seltener erscheint
Jede gelöste Abfrage kostet Zeit und Guthaben, und bei reCAPTCHA v3 entscheidet am Ende ohnehin der Score. Wirksamer ist es deshalb, die Bot-Erkennung gar nicht erst anschlagen zu lassen. Die folgenden Maßnahmen setzen genau dort an, wo reCAPTCHA hinschaut. In Octoparse lassen sie sich ohne Code einstellen.
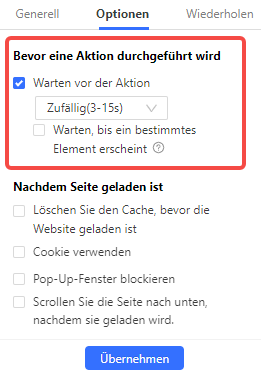
- Anfragen drosseln und Pausen variieren: Viele Abrufe im Sekundentakt sind das deutlichste Bot-Signal. Bauen Sie Wartezeiten ein und lassen Sie sie leicht schwanken. In Octoparse geht das pro Schritt über „Warten vor der Aktion“ in den Optionen.
- IP-Adressen wechseln: Kommen alle Anfragen von einer Adresse, fällt das schnell auf. Adressen aus Rechenzentren stehen zudem eher unter Verdacht als private Anschlüsse. Octoparse verteilt Cloud-Aufgaben auf wechselnde IP-Adressen, zusätzlich lassen sich unter „Anti-Blockierung“ eigene Proxys hinterlegen. Mehr dazu im Beitrag IP-Proxys: Vermeidung von Sperren beim Web Scraping.
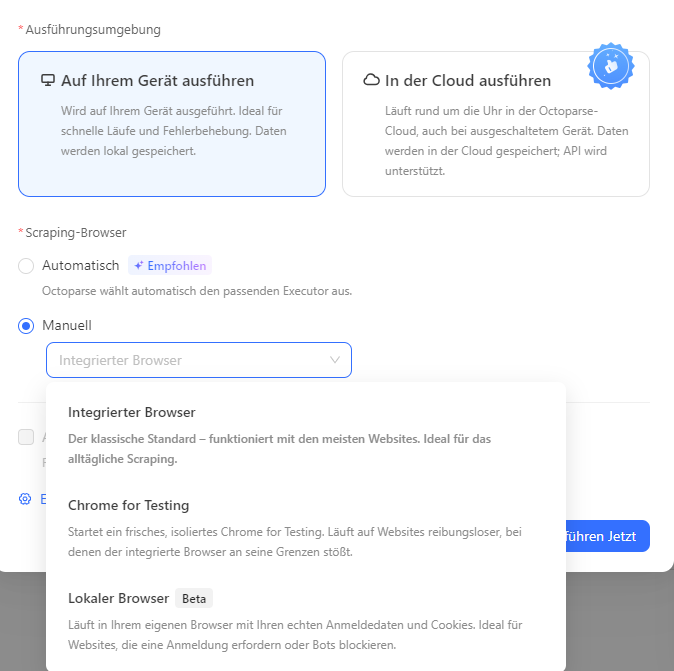
- Den passenden Browser wählen: Reine HTTP-Anfragen führen kein JavaScript aus und senden keine typischen Browser-Signale. Genau darauf achtet reCAPTCHA. Octoparse lädt Seiten deshalb immer in einem echten Browser und bietet beim Start einer Aufgabe unter „Scraping-Browser“ mehrere Varianten: den integrierten Browser als Standard und „Chrome for Testing“ für Websites, auf denen der integrierte Browser an seine Grenzen stößt. Bei Ausführung auf Ihrem eigenen Gerät kommt der „Lokale Browser“ (Beta) hinzu. Er nutzt Ihren eigenen Browser mit Ihren echten Cookies und Anmeldedaten und ist für Websites gedacht, die eine Anmeldung verlangen oder Bots blockieren. Achten Sie dabei darauf, nur Inhalte abzurufen, die Sie auch persönlich aufrufen dürfen. Mit der Einstellung „Automatisch“ wählt Octoparse den passenden Browser selbst.
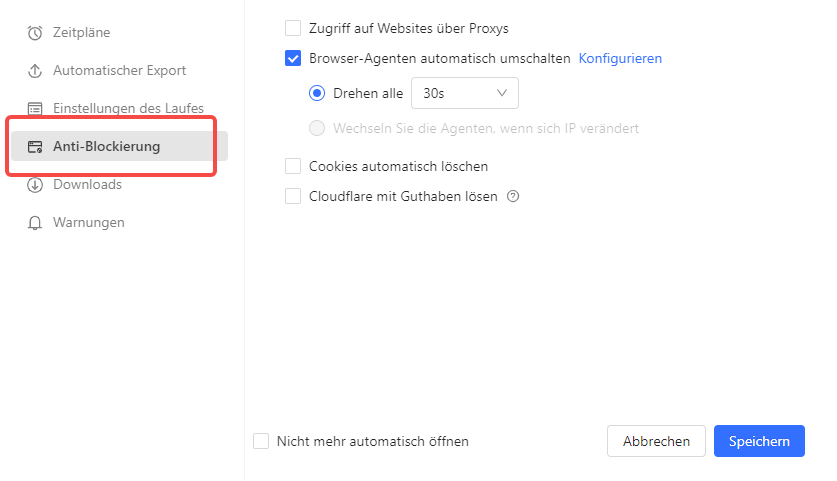
- User-Agent stimmig halten: Der User-Agent verrät, welcher Browser angeblich anfragt. Er sollte zum tatsächlichen Verhalten passen und nicht im Sekundentakt wechseln, denn ein Besucher, dessen Browser sich ständig ändert, wirkt eher verdächtig als einer, der immer gleich auftritt. In Octoparse aktivieren Sie dazu unter „Anti-Blockierung“ die Option „Browser-Agenten automatisch umschalten“ und legen fest, ob der Wechsel in einem festen Takt erfolgt oder zusammen mit der IP-Adresse. Am stimmigsten ist der Wechsel zusammen mit der IP, weil dann jede Adresse einem gleichbleibenden Browser zugeordnet ist. Über „Konfigurieren“ bestimmen Sie, welche Browser verwendet werden. Am unauffälligsten sind möglichst aktuelle Desktop-Browser. Als Googlebot sollte sich ein Scraper dagegen nicht ausgeben.
- Sitzungen und Cookies erhalten: Ein Besucher, der bei jeder Seite ohne Cookies neu ankommt, verhält sich unnatürlich. Behalten Sie Cookies innerhalb einer Erfassung bei. Die Option „Cookies automatisch löschen“ sollten Sie nur aktivieren, wenn eine Website Sie gezielt über Cookies wiedererkennt und blockiert.
- Last verteilen: Große Erfassungen lieber auf mehrere Läufe und ruhigere Tageszeiten aufteilen, statt eine Website in kurzer Zeit mit Tausenden Abrufen zu belasten. Das schont den Server und senkt zugleich die Wahrscheinlichkeit, dass Schutzmechanismen anspringen.
Weitere Maßnahmen gegen Sperren finden Sie im Beitrag Wie kann man Websites scrapen, ohne blockiert zu werden? Warum häufig die IP-Adresse der Auslöser ist, erklärt Warum wird meine IP-Adresse beim Scraping blockiert?
„Ich bin kein Roboter“ deaktivieren: Was normale Nutzer tun können
Wer gar nicht scrapt, sondern bei der Google-Suche ständig das Kästchen „Ich bin kein Roboter“ sieht, sucht meist nach einem Schalter zum Abschalten. Den gibt es nicht: Ob eine Website reCAPTCHA einsetzt, entscheidet allein ihr Betreiber. Laut Google erscheint die Abfrage, wenn aus Ihrem Netzwerk automatisierter Traffic kommt. Das muss nicht von Ihnen selbst ausgehen.
- VPN prüfen: Nutzen andere Kunden desselben VPN-Dienstes automatisierte Suchanfragen, trifft die Abfrage auch Sie. Schalten Sie das VPN testweise ab.
- Geteiltes Netzwerk bedenken: In Firmen, Hochschulen oder öffentlichen WLANs reicht ein Gerät, das automatisiert sucht. Hier kann nur der Netzwerkadministrator die Ursache finden.
- Auf Schadsoftware prüfen: Manche Malware sendet unbemerkt Anfragen an Google. Ein Virenscan schließt das aus.
- Browser prüfen: Erscheint gar keine Aufgabe, ist oft JavaScript deaktiviert oder der Browser wird von reCAPTCHA nicht unterstützt.
Hilft das alles nicht, ist der Internetanbieter der richtige Ansprechpartner. Übrigens: Auch Scraper, die Google-Suchergebnisse auslesen, zählt Google ausdrücklich zum automatisierten Traffic. Die Tipps weiter oben gelten deshalb in beide Richtungen.
Fazit
Welcher Weg passt, hängt weniger vom CAPTCHA selbst ab als davon, wie oft und in welchem Umfang Sie Daten brauchen.
Wer einmalig ein paar hundert Einträge erfasst, kommt mit gedrosseltem Tempo und einem echten Browser oft durch, ohne eine einzige Abfrage lösen zu müssen. Wer regelmäßig größere Mengen braucht und nicht programmieren will, ergänzt in Octoparse den Schritt „CAPTCHA lösen“, lässt die Aufgabe in der Cloud über wechselnde IP-Adressen laufen und richtet eine Warnung ein, die anschlägt, sobald die Lösungsversuche steigen. Eigener Code mit Solver-Dienst lohnt sich vor allem für Teams, die ohnehin Entwickler für ihre Datenpipeline beschäftigen.
Für alle drei gilt: Je seltener eine Abfrage erscheint, desto stabiler läuft die Erfassung und desto geringer ist das rechtliche Risiko. Ein guter Scraper zeichnet sich nicht dadurch aus, dass er CAPTCHAs geschickt löst, sondern dadurch, dass er kaum welche zu sehen bekommt.
FAQ
Kann man reCAPTCHA beim Scraping automatisch lösen?
Ja, bei den meisten Varianten. In Octoparse übernimmt der Schritt „CAPTCHA lösen“ Bild-CAPTCHAs, reCAPTCHA v2 mit und ohne Kästchen, reCAPTCHA v3 und Cloudflare-Prüfungen während der Datenerfassung. Bei reCAPTCHA v3 entscheidet am Ende allerdings der Score, den die Website auswertet. Ob ein Zugriff durchgeht, hängt deshalb auch davon ab, wie unauffällig die Aufgabe insgesamt läuft.
Was ist der Unterschied zwischen reCAPTCHA v2 und v3?
reCAPTCHA v2 zeigt eine sichtbare Prüfung: das Kästchen „Ich bin kein Roboter“ und bei Verdacht eine Bildaufgabe. reCAPTCHA v3 läuft komplett unsichtbar und vergibt für jede Anfrage einen Score zwischen 0,0 und 1,0. Was bei einem niedrigen Wert passiert, legt die Website fest. Für Scraper heißt das: v2 lässt sich lösen, bei v3 kommt es vor allem darauf an, gar nicht erst wie ein Bot zu wirken.
Was kostet das automatische Lösen von CAPTCHAs in Octoparse?
Abgerechnet wird über ein separates Guthaben, nicht über den Tarif. Octoparse berechnet 1 $ pro 1.000 Lösungsversuche (Stand 10/2026). Jeder Versuch zählt, auch ein erfolgloser, und ein einzelnes CAPTCHA kann mehrere Versuche brauchen. Wer Abfragen durch gedrosseltes Tempo und wechselnde IP-Adressen seltener auslöst, spart deshalb auch Geld.
Was ist ein CAPTCHA-Solver?
Ein CAPTCHA-Solver ist ein Dienst, an den ein Scraper die Abfrage per API weiterreicht. Dort wird sie automatisiert oder von Menschen gelöst, zurück kommt ein Token, das der Scraper an die Website übermittelt. Solche Dienste rechnen meist pro 1.000 Lösungen ab und setzen Programmierkenntnisse voraus. Bei reCAPTCHA v3 garantiert auch ein gültiges Token keinen Zugang, weil weiterhin der Score zählt.
Warum fragt Google ständig „Ich bin kein Roboter“?
Laut Google erscheint die Abfrage, wenn aus Ihrem Netzwerk automatisierter Traffic kommt. Häufige Ursachen sind ein VPN, das auch andere für automatisierte Anfragen nutzen, ein geteiltes Netzwerk in Firma oder Hochschule oder Schadsoftware auf einem Gerät. Abschalten lässt sich die Abfrage nicht. Was Sie stattdessen tun können, steht im Abschnitt für normale Nutzer weiter oben.